
STAMP scaled scores provide a more detailed measure of language proficiency than benchmark levels alone. They can help educators identify differences in performance within the same proficiency level and track student progress over time.
This article explains how STAMP scaled scores are calculated, how to interpret them, and what to consider when comparing results.
什么是分数缩放?
当测试开发者向最终用户(学校管理员、教师、家长、考试参与者本人或其他可能的分数使用者)报告测试分数时,确保所报告的数字分数的含义清晰易用非常重要。如果不能做到这一点,那测试分数又有什么意义呢?
测试成绩可以有许多不同的形式。
例如,某些测试的分数以正确数量或正确百分比的形式报告。在每一个考生都参加完全相同的测试的情况下,这种报告方式非常有用,就像线性的,固定形式的测试一样。
Avant STAMP (STAndards-based Measurement of Proficiency) 评估,然而,采用更现代的心理测量学和测试开发方法,而且不是线性测试。所有的 STAMP 阅读和听力测试都是计算机适应性的,这意味着测试的难度会根据每个考试者的估计语言能力实时调整。这导致了对考试者语言熟练度的更准确测量,并为考试者提供了比通常线性测试更愉快的体验,因为考试者不会遇到大量远低于或高于他们实际熟练度水平的项目。这种强大的测试组装和部署方法只能通过一种称为项目反应理论(IRT)的心理测量技术实现。在IRT中,每个测试项目(也称为测试问题)都与其自身的科学测量难度级别相关联。在 STAMP 的情况下,通过对数百(在许多情况下,数千)代表性考试者的反应进行IRT分析,计算出测试中每个项目的难度级别。这使我们能够校准项目的难度,并确保只有最好的项目被用于每个 STAMP 测试。
STAMP评分算法也利用这个项目难度信息来计算每个考生的最终STAMP等级,这是基于他们在考试中尝试的项目,他们对每个项目的反应,以及考生需要展示的能力,以便在每个STAMP等级上得分(后者是通过一个被称为标准设定的过程来确定的)。因此,鉴于STAMP评估的适应性质,以及每个项目都有一定的统计难度等级,以正确数量(例如,23个中的30个)或正确百分比(76.6%)来报告STAMP分数既没有意义也不合适。
正如我们即将讨论的,项目反应理论(IRT),它构成了Avant STAMP 测试的开发和评分的统计基础,使用的分数尺度对STAMP 测试的最终用户来说并不直观。例如,IRT尺度具有负值和正值。在他们的分数报告中告诉一个考生,他们在德语STAMP 4S测试中的阅读熟练度是-1.4,这将不会有任何帮助,而且会违反上述对清晰易用的分数的要求。因此,有必要将基于IRT的STAMP 分数值转换为更有意义且易于解释的分数尺度。尺度基本上是潜在测量值的谱系,测试开发者必须在分数可以报告之前决定分数尺度的参考点。
理解刻度的参考点
读者可能熟悉的三种刻度是摄氏度,华氏度和开尔文温度刻度。尽管这三者都是温度刻度,但它们的参考点和解释方式却有很大的不同。同样的情况也可以应用于用于报告语言熟练度分数的不同刻度。
在摄氏温度计上,0℃表示海平面上水冻结的测量点,而摄氏温度计上可能的最小测量值是-273.15℃,这是物质中没有任何分子活动的点。然而,在华氏温度计上,海平面上水冻结的测量点是32华氏度,不是0华氏度。在华氏温度计上,-459.67 F表示可能的最小测量值,即物质中没有分子活动的时候。正如我们所看到的,无论是在摄氏温度计还是华氏温度计上,零并不实际意味着某物的完全缺失。它只是一个参考点,只有在考虑到完整的温度计和其可能达到的值时才有意义。
对于温度刻度,唯一具有真正零点的刻度是开尔文刻度。在开尔文刻度中,0 K测量点实际上意味着没有任何分子活动,零标记了开尔文刻度中可能的最小值。因此,在开尔文刻度中,负值是不可能的,这与摄氏度和华氏度刻度(以及我们将很快看到的IRT刻度)不同。所有三种温度刻度都没有真正的最大值限制,因为我们还不知道某物可以有多热。
现在,我们真的可以说一种刻度比另一种刻度更好吗?其实并不能。这三种刻度各自都完全有效,并且在不同的情境中被广泛使用,某些刻度根据特定情境被用户认为更适当。然而,将这三种刻度统一起来的一件事,也使它们非常适合精确测量,那就是刻度中任意两个测量点之间的距离表示的温度差异是相同的。换句话说,35℃和37℃之间的分子活动差异与89℃和91℃之间的差异完全相同。这是我们在Avant认为是良好测量的核心特性,当然也是我们用于我们的STAMP分数的特性。
尽管观察上述三种熟悉的温度刻度并了解它们在各自的测量环境中对于测量像温度这样的构造的适用性是有用的,但重要的是要理解它们所具有的一些特性使得它们不适合测量像语言熟练度这样的构造。例如,人们会发现几乎无法解释什么是负的语言熟练度,或者如何可能有人在一种语言中的能力为零;即使是一个从未学过或接触过某种语言的人,也会对该语言中至少有一些(虽然最少)的借用词有所了解。没有任何语言熟练度测试可以声称某人的语言熟练度为零,因为对于任何一种测试来说,都不可能评估出一个人可能在某些情况下,即使是非常基础的,对语言中的一个词或短语的理解。所有的语言测试都受到测试中存在的项目及其能够测量的内容的限制,这意味着语言测试可能没有零点的测量,但可能有一个最小的测量点,代表测试无法做出任何声明的点。同样的,测试中的最大参考点也是如此;无论一个测试包含多少项目,它都无法测量一个人所有的语言熟练度。因此,像STAMP测试这样的语言熟练度测试的有效刻度将有一个最小参考点(用于所有看到的测试项目都回答错误的考生),没有零参考点,并且将有一个最大参考点(用于回答所有看到的测试项目都正确的考生)。
IRT测量和STAMP分数
如上所述,重要的是,用于报告语言熟练度测试分数的量表中的等间隔应表示相同的语言熟练度差异。所有来自STAMP测试的级别(1 - 9级)都与美国语言熟练度标准级别(从初级低级到高级高级)对齐,如下所示:
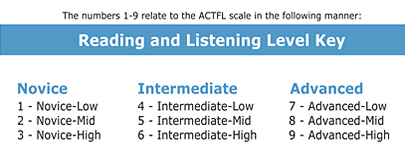
尽管STAMP等级与这些熟练程度等级对齐,尽管熟练程度等级对于指示考生在语言中的一般能力水平具有用处,但标准等级本身并不符合我们正在寻找的数字刻度分数的类型。首先,国家熟练程度标准(因此STAMP)等级之间的间隔差异的含义并非在刻度上的任何点都是相同的。例如,从中级高级(STAMP等级6)提升到高级初级(STAMP等级7)所需的语言能力比从初级高级(STAMP等级3)提升到中级初级(STAMP等级4)所需的更高。正因为此原因,熟练程度等级被描绘为一个倒置的金字塔,而不是一个正方形或矩形。其次,尽管熟练程度等级对于指示某个语言学习者在他们的语言熟练程度方面的位置具有用处,但在同一STAMP等级上得分的学生实际上可能在语言中具有略微不同的能力,并且可能在STAMP测试中正确回答了不同数量的项目,即使他们碰巧通过STAMP自适应算法看到了完全相同的项目。因此,尽管STAMP和国家熟练程度标准等级在理解考生的语言熟练程度方面具有重要的用途,但这些等级并不像我们的测试分数的一些最终用户希望的那样细致。
例如,一所学校的法语阅读荣誉班可能只有十个名额。如果有十四个学生达到了STAMP 9级阅读水平呢?学校该如何从这14个学生中挑选出10个进入荣誉班呢?随机挑选十个可能被认为是一个可接受的解决方案,但我们Avant Assessment可以提供一种更好、更准确的帮助方法。如上所述,Avant Assessment使用一种称为项目反应理论的统计测量技术来校准(自适应) STAMP 测试的阅读和听力部分中的所有项目,以便将考生在特定测试路径中正确回答的问题数量与STAMP 等级以及他们对应的全国熟练度标准等级对齐,并最终产生标度分数,这为评分用户提供了比仅报告STAMP等级更细致的语言能力测量。
缩放STAMP分数
一旦STAMP测试的特定部分中的所有项目通过IRT进行了校准,我们就能够根据学生在阅读和听力部分的STAMP测试中所走的特定路径中正确或错误的项目,为每个学生分配一个IRT能力估计值(在IRT术语中也被称为theta)。一旦我们有了这个值,我们就能够调整这个值(因此有了得分调整这个术语),以便我们可以报告更细致的分数,以补充报告所达到的STAMP级别。通过调整IRT分数,我们就能确保所有的调整分数都是正的(没有负值),并且得分用户,比如上述的法国学校,能够更深入地了解学生的熟练程度,即使学生恰好在STAMP级别上得分相同。
每个STAMP测试的阅读和听力部分都必须单独进行量表评分。因此,西班牙语阅读的量表分数不能直接与西班牙语听力的量表分数,或者与中文阅读的量表分数进行比较。换句话说,STAMP的量表分数是针对语言和部分的特定评分。
我们通过简单的线性转换来量化我们每个测试中阅读或听力部分的IRT分数,如下面的公式所示:

上述的缩放确保了给定STAMP测试部分的所有可能缩放分数都是没有小数的正数,这比从-4到+4的分数范围更直观,后者是IRT更常见的。上述公式中看到的线性缩放也确保了任何两个缩放分数之间的距离在任何点的尺度上都表示了相同的能力差异。
解释缩放分数
想象一下,我们有以下学生,他们参加了日语STAMP 4S 测试的听力部分:
- 学生A的标准分数:589
- Student B 的标准分数:612
- Student C 的标准分数:677
- Student D 的标准分数:700
学生A和学生B在日语听力熟练度上的差异(23个标度分)与学生C和学生D在日语听力熟练度上的差异(23分)相同。如果两个学生在日语听力STAMP级别上达到了相同的水平(例如,STAMP级别4 - 中级低级),但其中一个学生的标度分数比另一个学生高出20分,我们有强有力的理由相信,得分较高的学生比得分较低的学生更熟练。他们的标度分数之间的差异越大,我们就越有信心认为这种差异是有意义的,这两个学生的熟练度确实不相等。在某些情况下,标度分数也可能有用,例如,一个学生可能在学习一年后似乎没有取得进步,而且在相同的熟练度级别上“停滞不前”。比较他们一年前的标度分数和他们当前的标度分数可能会显示出他们的熟练度有小幅度的增长,即使这样的增长不足以让他们进入下一个STAMP级别。
然而,有一件事应该牢记在心:所有评估都有一定的测量误差与其分数相关联。例如,教育测试服务(ETS)报告的托福iBT听力部分的标准测量误差(SEM),其使用的分数范围从0 - 30,是2.38个刻度点(教育测试服务,2018)。反过来,对于SAT部分得分,得分范围为200 - 800,标准测量误差为30点(大学理事会,2018)。由于不可行的是在许多不同的日子和数百个测试项目中评估每个学生,因此每个测试结果都是测试者在他们进行测试的那一天以及他们在测试期间回答的特定项目中能够维持的水平的快照。自然,像STAMP 4S这样的测试,其阅读和听力部分是计算机适应的,包括大量针对每个测试者实时估计水平的项目,并且是根据严格的定性和定量标准开发的,将倾向于具有较小的测量误差,并且比较短,非适应性,线性测试更有效和高效,这些测试不遵循相同的严格性(Schultz,Whitney,& Zickar,2014)。STAMP测试的阅读和听力部分的刻度分数的平均标准测量误差是10个刻度分数点。我们在Avant使用的IRT软件类型可以轻松导出此统计数据。
与STAMP量表分数相关的测量误差相当小,考虑到我们测试的心理测量学严谨性和适应性。尽管我们建议主要根据达到的STAMP级别进行测试分数分析,但我们Avant建议,在需要根据STAMP测试分数做出更高风险决策的非常特定的情况下,可能会考虑量表分数,例如,当STAMP分数被用来授予州双语能力印章(SSB)或通过考试授予学分(CBE)时。在这种更高风险的情况下,如果考生的阅读或听力量表分数恰好在可以使他们有资格获得SSB或CBE的最低量表分数的10分或更少的范围内,Avant的立场是,学校或区域可以自行决定让这些考生重新参加STAMP测试(考虑到其适应性,考生可能不会看到与上次考试完全相同的题目)。如果在这第二次考试中,考生的量表分数达到了满足SSB或CBE要求的STAMP级别,Avant的立场是,这第二次考试的分数可以代替第一次考试的分数。
上述讨论的两种情况都是高风险的情况,在这些情况下可能需要考虑测试的小误差范围(请记住所有测试都有误差范围)。
我们建议通常适合使用STAMP标度分数进行传统的使用,例如进行持续的年度分析或学生的成长,以及进行项目评估。
要查看当前可用的STAMP评估的标度分数表,请点击这里。
References
College Board (2018)。SAT:理解分数。从https://collegereadiness.collegeboard.org/pdf/understanding-sat-scores.pdf检索
Educational Testing Service. (2020). Reliability and Comparability of TOEFL iBT Scores. TOEFL Research Insight Series (Vol. 3). Retrieved from https://www.ets.org/pdfs/toefl/toefl-ibt-insight-s1v3.pdf.
Schultz, K. S., Whitney, D. J., & Zickar, M. J. (2014). 测量理论实践.案例研究和练习 (第二版). 伦敦/纽约: Routledge. College Board (2018). SAT: 理解分数. 从https://collegereadiness.collegeboard.org/pdf/understanding-sat-scores.pdf检索
Schultz, K. S., Whitney, D. J., & Zickar, M. J. (2014). Measurement Theory in action. Case studies and exercises (2nd ed.). 伦敦/纽约: Routledge.